Polymarket 订单簿数据
每一次订单簿更新,每侧 25 档。
Polymarket 上的每个结果都在各自的中央限价订单簿上交易:同一代币的挂单买价与卖价,以概率的美分计价。L2 表会在平台广播的每一次变化时记录这本订单簿,作为每侧最优 25 个价位的完整快照,包含每一档的数量和纳秒级接收时间戳。下文介绍这张表包含什么、一本订单簿一天下来是什么样子,以及它实际有多深:全部在免费样本上,用一个你可以自己运行的脚本测得。
Polymarket 公开 API 能提供什么
Polymarket 的 CLOB API 回答的是关于当下的问题。/book 返回某个结果代币当前的挂单买卖盘,并附带一个哈希值,方便你判断两次读取之间订单簿是否变化;它不接受时间参数。/prices-history 只返回时间戳与价格对,没有买价、卖价、数量或深度;我们请求一个上线两周的市场在整个存续期内的一分钟精度数据时,它返回的数据点间隔十分钟。市场 websocket 确实会实时推送每一次订单簿变化,但只推给当时在线连接的人。
所以,一本订单簿的历史只有在有人录制时才存在。我们自 2026-05-11 起一直在持续录制,订单簿历史可追溯至 2026 年 2 月。这就是本页介绍的数据。
L2 订单簿文件里有什么
每个结果代币的每次订单簿更新对应一行。每一行都是更新之后的完整订单簿,而不是增量:最优 25 个买价和最优 25 个卖价,含价格和数量,超出现有最后一档的位置以 NaN 填充。样本当天,平台重发整本订单簿 9,819 次,发送增量变化 630,916 次;两者都以完整快照存储,通过 event_kind 区分。数量单位为份额(合约),因此某一档的美元深度等于价格乘以数量。
l2.parquet — one row per book update per outcome tokents_recv_ns int64 our receive time, ns since epoch (authoritative order)ts_src_ms int64 the venue's own timestamp, mscondition_id str the markettoken_id str the outcome (YES or NO leg) — read as a stringevent_kind str "snapshot" (venue resent the whole book) | "update"source_event_type str upstream message: book | price_changemsg_seq int64 capture sequence numberbid_levels int16 price levels in the WHOLE bid book (the file keeps 25)ask_levels int16 price levels in the whole ask bookbest_bid, best_ask float64 top of book, rebuilt from the levelspayload_best_bid float64 top of book as the venue's message declared itpayload_best_ask float64bid_ask_reconciles bool rebuilt top of book == declared top of bookbid_px_1 … bid_px_25 float64 price per level, best first, NaN past the bookbid_sz_1 … bid_sz_25 float64 size per level, in shares (contracts)ask_px_1 … ask_px_25 float64ask_sz_1 … ask_sz_25 float64
Premium 和 Custom 套餐包含全部 25 档;Explorer 和免费市场·日包含最优 10 档。数据包还包含 L1(每次变化时的盘口最优价),以及自 2026-04-13 起的成交记录。完整参考见 schema 文档(英文)。
一本订单簿的一天:深度热力图
“Bitcoin Up or Down - August 19, 4:00PM-8:00PM ET”的 YES 一侧,时间为该问题覆盖的四个小时。每个格子代表一分钟、一美分的价格区间;亮度表示挂在该处的美元数量,按秒取平均。买单为绿色,位于中间价下方;卖单为红色,位于中间价上方;圆圈表示成交。
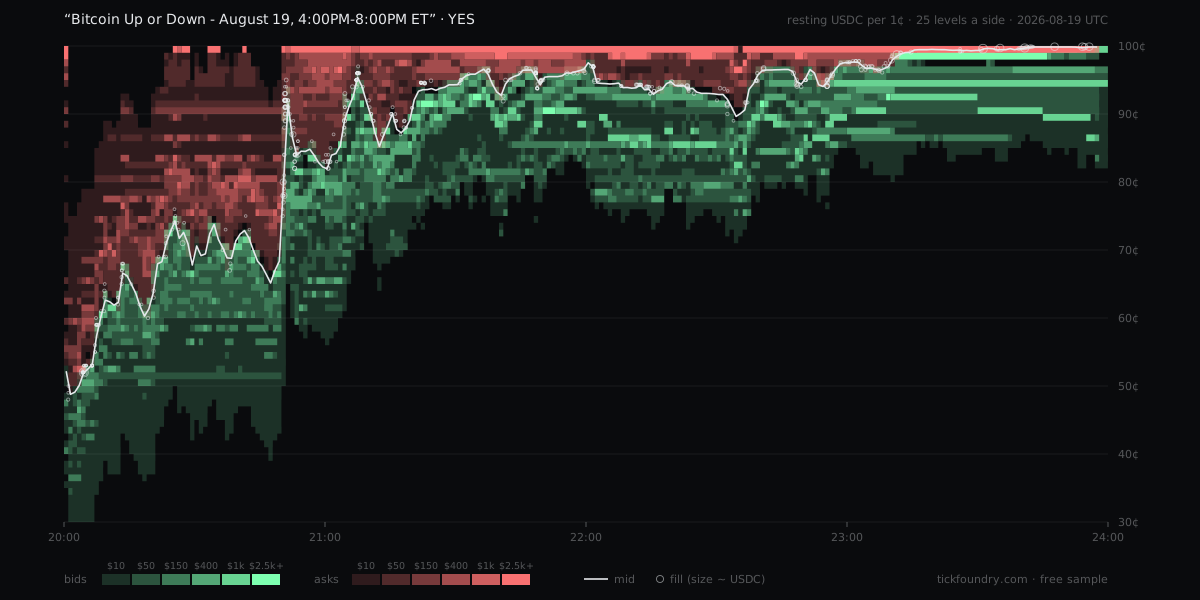
看 21:00 前的那次跳升。20:49:44 UTC 时中间价为 68¢,六十秒后变为 93¢。在这一分钟里,YES 订单簿变化了 2,049 次,产生了 15 笔成交,合计约 $1,400。成交记录只能告诉你这些,剩下的要看订单簿:这一分钟开始时,69¢ 到 93¢ 之间挂着 $5,680 的卖单;结束时最优卖价为 94¢。价格图能显示这次跳升;只有订单簿能告诉你当时能否成交穿过这段价格,以及能成交多大规模。
订单簿深度与价差:实际有多深
同一市场、同一时间窗口,每秒采样一次,使一阵密集更新按其持续的时间计入,而不是按它产生了多少条消息计入。价差取最优卖价减最优买价。
| 价差 | ≤ 1¢ | 1–2¢ | 2–5¢ | > 5¢ | 中位数 |
|---|---|---|---|---|---|
| 时间占比 | 63.9% | 20.6% | 15.5% | 0.0% | 1.0¢ |
14,274 个双边均有报价的秒 · 2026-08-19 20:00–24:00 UTC
| 挂单范围 | 买单 · 中位数 | 买单 · p10 | 卖单 · 中位数 | 卖单 · p10 |
|---|---|---|---|---|
| 中间价 ±1¢ 以内 | $256 | $0 | $141 | $0 |
| 中间价 ±2¢ 以内 | $944 | $102 | $294 | $76 |
| 中间价 ±5¢ 以内 | $2,260 | $719 | $2,918 | $419 |
USDC(价格 × 数量)· p10 = 深度最薄的 10% 秒数
| 档位 | 该档买单 | 累计买单 | 该档卖单 | 累计卖单 | 该卖档存在 |
|---|---|---|---|---|---|
| 1 | $110 | $110 | $77 | $77 | 100% |
| 2 | $130 | $305 | $95 | $196 | 93% |
| 3 | $99 | $568 | $88 | $304 | 93% |
| 5 | $98 | $936 | $98 | $606 | 85% |
| 10 | $66 | $2,428 | $74 | $2,378 | 77% |
| 25 | $40 | $4,736 | $53 | $10,480 | 25% |
该档位的 USDC 中位数,以及从最优价累计到该档的总额 · 买方在 99.9% 的秒数里 25 档齐全
有三点值得注意。盘口很薄:最优买价挂单的中位数为 $110,最优卖价为 $77,所以稍大一点的订单都会逐档吃穿价格档位。中间价附近的深度时有时无:至少有十分之一的秒数里,某一侧在中间价 1¢ 以内没有任何挂单。而且两侧并不对称:在三分之二的时间窗口里价格高于 90¢,中间价与 100¢ 之间空间很小,订单簿的中位数是 111 个买价档位对 17 个卖价档位。这些都无法从价格序列中看出来。
用 pandas 复现
以上三张表背后的脚本,原样呈现。解压样本,在数据包目录中运行;也可以用在你下载的任何其他市场·日上:它会自动选出文件中最活跃的市场及其对应的时间窗口。
# pm_depth.py — how deep was a Polymarket order book, level by level and near the mid?# Runs on the free sample bundle: https://tickfoundry.com/samplesimport numpy as npimport pandas as pdl2 = pd.read_parquet("l2.parquet") # one full 25-level snapshot per book updatemarkets = pd.read_csv("reference/markets.csv")# The YES leg of the day's busiest market, over the four hours its question covers.busiest = l2.groupby("condition_id").size().idxmax()m = markets.set_index("condition_id").loc[busiest]book = l2[l2.token_id == str(m.yes_token_id)].sort_values("ts_recv_ns").reset_index(drop=True)end = pd.Timestamp(m.end_time)start = end - pd.Timedelta(hours=4)# Sample the book once a second so every statistic is time-weighted:# a burst of 50 updates inside one second counts as one second, not as 50.grid = np.arange(start.value, end.value, 1_000_000_000)at = np.searchsorted(book.ts_recv_ns.to_numpy(), grid, side="right") - 1snap = book.iloc[at[at >= 0]]snap = snap[snap.best_bid.notna() & snap.best_ask.notna()] # drop one-sided secondspx = {s: snap[[f"{s}_px_{i}" for i in range(1, 26)]].to_numpy() for s in ("bid", "ask")}usd = {s: px[s] * snap[[f"{s}_sz_{i}" for i in range(1, 26)]].to_numpy() for s in ("bid", "ask")}mid = ((snap.best_bid + snap.best_ask) / 2).to_numpy()[:, None]spread = (snap.best_ask - snap.best_bid).to_numpy() * 100 # cents; never the rounded spread columnprint(m.question, f"· {start:%Y-%m-%d %H:%M} to {end:%H:%M} UTC")print(f"{len(book):,} book updates for this token on the day, "f"{((book.ts_recv_ns >= start.value) & (book.ts_recv_ns < end.value)).sum():,} inside the window; "f"{len(snap):,} two-sided seconds sampled\n")print("spread (¢) median", round(np.median(spread), 2),"| ≤1¢", f"{np.mean(spread <= 1.0001):.1%}","| 1–2¢", f"{np.mean((spread > 1.0001) & (spread <= 2.0001)):.1%}","| 2–5¢", f"{np.mean((spread > 2.0001) & (spread <= 5.0001)):.1%}","| >5¢", f"{np.mean(spread > 5.0001):.1%}\n")rows = []for c in (1, 2, 5): # USDC resting within c cents of the midbid = np.nansum(np.where(px["bid"] >= mid - c / 100 - 1e-9, usd["bid"], 0), axis=1)ask = np.nansum(np.where(px["ask"] <= mid + c / 100 + 1e-9, usd["ask"], 0), axis=1)rows.append({"within": f"±{c}¢", "bid median $": np.median(bid), "bid p10 $": np.percentile(bid, 10),"ask median $": np.median(ask), "ask p10 $": np.percentile(ask, 10)})print(pd.DataFrame(rows).round(0).to_string(index=False), "\n")rows = []for lvl in (1, 2, 3, 5, 10, 25): # size at each level, and through itrows.append({"level": lvl,"bid $ at level": np.nanmedian(usd["bid"][:, lvl - 1]),"bid $ through": np.median(np.nansum(usd["bid"][:, :lvl], axis=1)),"ask $ at level": np.nanmedian(usd["ask"][:, lvl - 1]),"ask $ through": np.median(np.nansum(usd["ask"][:, :lvl], axis=1)),"ask levels present": f"{np.mean(~np.isnan(px['ask'][:, lvl - 1])):.0%}"})print(pd.DataFrame(rows).round(0).to_string(index=False), "\n")print("price levels in the whole book (the file keeps the best 25 a side): median bid",int(np.median(snap.bid_levels)), "· ask", int(np.median(snap.ask_levels)))
如果想用这本订单簿为订单定价,而不只是描述它,请看如何回测 Polymarket,其中用 $100、$500 和 $2,000 的市价买单逐档走过同一个价格档位。
Polymarket 订单簿数据能用来做什么
归档中的两个实例:西班牙对比利时的四分之一决赛(英文),价格波动 64 个点期间价差扩大到 31¢;以及从订单簿看世界杯决赛(英文)。
常见问题
免费账户可在 2026 年 7 月的任意日期中领取 5 个市场·日,schema 完全相同,pm_depth.py 无需改动即可在每一个上运行。无需绑卡。